NumpyNN 系列导航
这是一个使用 NumPy 动手实现轻量神经网络库的系列,记录实现过程中学习到的神经网络基础知识。
碎碎念:习惯了用PyTorch写神经网络模型,每一次按下 nn. 都觉得不踏实。所以趁此假期用numpy来写一个轻巧的神经网络库,暂且命名为NumpyNN,托管于GitHub。一方面巩固一下神经网络基础知识,另一方面规范一下Python代码风格,还能顺便学一些Python的的高级语法糖。此文记录该过程中学到的一些琐碎知识点,不断更新…
因为多种因素,项目目前仍在开发中。
一个简单的全连接层即为对输入 做一次仿射变换:
其中, 为该层参数,为该全连接层输入,为输出。
Numpy实现如下:
def forward(X):
return X @ w + bW和b为需要初始化的参数,且在训练过程中,通过反向传播来更新。那么反向传播如何更新参数,已经反向传播如何进行?
以下图为例,下图展示了一个典型两层的神经网络。其中黑线表示正向传播,红线表示反向传播。
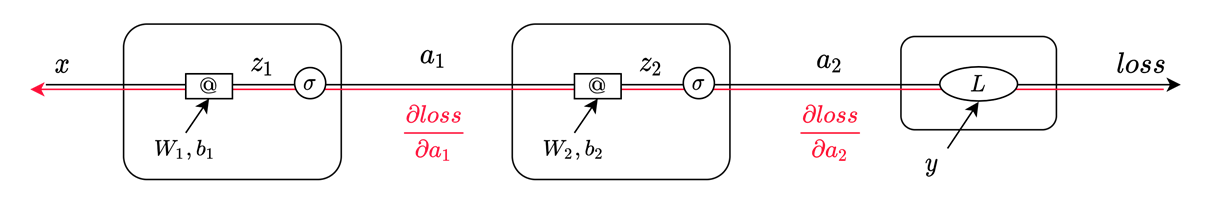
正向传播:
初始输入 经过第一层全连接层得到 ,再经过激活函数得到 。 作为第二层网络的输入,同样经过一个全连接层 和一个激活函数得到了 , 即为网络的输出,即 的预测值,最后 预测值 和真实值 经过损失函数得到 损失值 .
反向传播:
反向传播的本质是计算损失值 对参数 的偏导,因为参数是通过梯度下降的方式更新的,用到了偏导,例如参数 的更新过程如下:
计算偏导可以通过偏微分的定义求得,但是当神经网络层数较多时,按定义的计算复杂度会很高,所以一般不会采用这种方式,而是通过基于链式法则的计算图来计算,即通常所说的反向传播。
在基于链式法则的计算图中,偏导计算方式如下:
注:以上表达式是错误的,矩阵求导不同于标量求导,这里只是为了传达链式法则的精髓!
可见,在对 求偏导时,用到了 对该层输出值 的偏导,即 .
因此,反向传播中,从后往前传递的是 对 该层输出值偏导。然后在该层内部,可以利用传递回来的偏导计算得到该层参数的偏导,同时,还需要把 loss 对该层输入(即前一层输出)的偏导传递到前一层,供前一层计算。代码如下:
def backward(self, pre_grad):
    dw = X.T @ pre_grad
    db = np.mean(pre_grad, axis=0)
return pre_grad @ W.T其中per_grad 为 loss 对 该层输出的偏导。dw, db 为该层参数的偏导,需要先保存下完,等反向传播完成后,更新一次参数。return 值为loss对该层输入(即上一层输出)偏导,要传递给上一层,作为上一层神经网络的pre_grad参数。
到此,一个简单的全连接层即可搭建完成,完整代码如下:
class Linear:
    def __init__(self, in_features, out_features):
        self.w = None
        self.b = None
        self.dw = None
        self.b = None

        self.in_features = in_features
        self.out_features = out_features
        self._init_params()

    def _init_params(self):
        mu = 0
        sigma = np.sqrt(2 / (self.in_features + self.out_features))
        self.w = np.random.normal(mu, sigma, (self.in_features, self.out_features))
        self.b = np.zeros((1, self.out_features))


    def forward(self, input):
        self.input = input
        return input @ self.w + self.b

    def backward(self, pre_grad):
        self.dw = self.input.T @ pre_grad
        self.db = np.mean(pre_grad, axis=0)
        return pre_grad @ self.W.T

    def __call__(self, *args, **kwargs):
        return self.forward(*args, **kwargs)